Alibaba dévoile sa puce IA la plus puissante et ouvre sa pile logicielle
À la conférence Yunqi, le groupe chinois a annoncé la puce Zhenwu V900, présentée comme l'accélérateur IA chinois le plus puissant. Le lendemain, sa filiale T-Head a publié en open source les composants de sa pile logicielle SAIL.
 Sophie LeclercIA, modèles et technologies
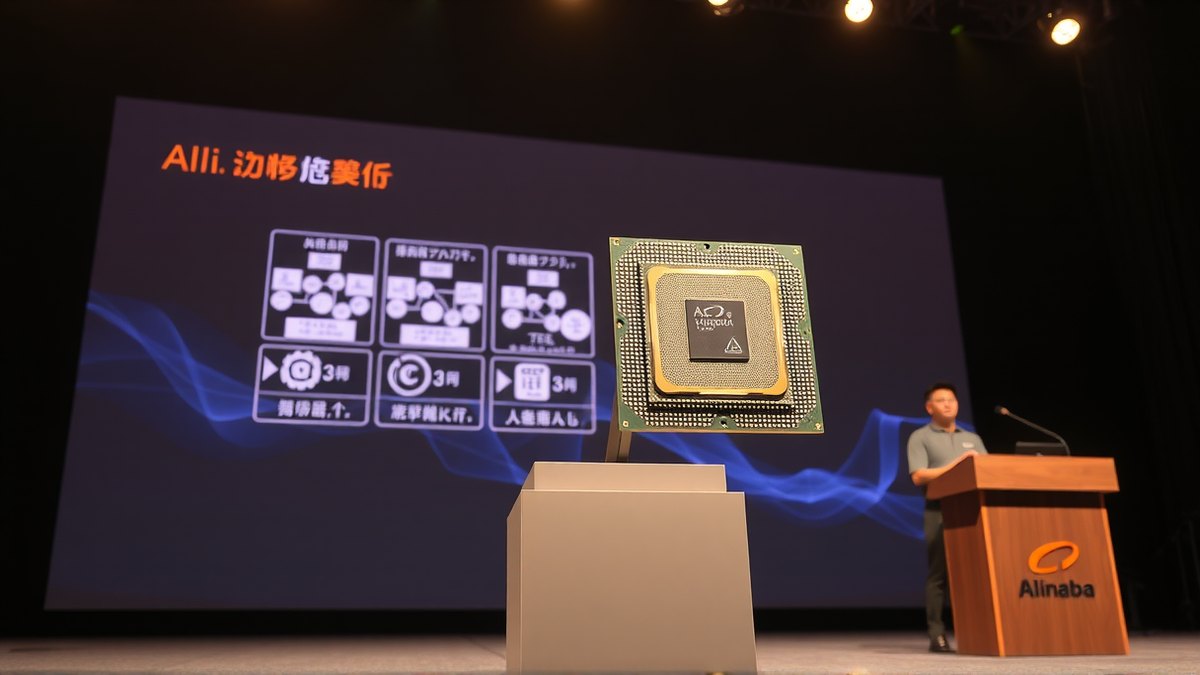
Le 22 septembre, à la conférence Yunqi de Hangzhou, le directeur général d'Alibaba Wu Yongming a présenté le nouvel accélérateur 真武 V900. Selon le groupe, c'est la puce IA chinoise la plus puissante, avec des performances trois fois supérieures à celles du M890, le modèle de la génération précédente. Un jour plus tard, la filiale T-Head a publié les avancées open source de la pile logicielle qui l'accompagne.
Ce qui a été ouvert
Le paquet, baptisé T-Head SAIL, comprend l'adaptation des frameworks de calcul, les bibliothèques d'accélération, la chaîne d'outils et les bibliothèques de communication. La publication fait apparaître les composants PyTorch-for-sail, sailify, Triton-for-sail, DeepGEMM-for-sail et FlashAttention-for-sail. PCCL et DeepEP-for-sail sont annoncés comme à venir. Ouvrir les outils et pas seulement le silicium répond à un objectif précis : rendre la puce adoptable sans réécrire les modèles existants.
Alibaba revendique plus de 650 clients dans plus de 20 secteurs, dont Ant, Xiaohongshu et le constructeur automobile XPeng. Xiaohongshu, en particulier, a développé des agents capables de gérer la migration des charges et l'optimisation des opérateurs. Le catalogue ModelScope compte 39 modèles quantifiés, parmi lesquels Qwen, DeepSeek et Kimi, avec plus de 348 000 téléchargements en septembre 2026. L'avantage se joue donc autant sur la communauté de développeurs que sur les performances.
Le calcul reste rare
En arrière-plan, il y a un problème d'offre. Le rapport conjoint présenté par Inspur à l'AICC 2026 avec IDC estime que le taux de couverture de la demande mondiale de capacité de calcul pour l'IA passera de 79 % en 2024 à 71 % en 2027, avant de remonter à 77 % en 2030. L'écart absolu est évalué à 380,9 milliards de dollars en 2030, près de dix fois la valeur de 2024. La consommation mondiale de tokens devrait croître à un taux annuel composé de 4 822,6 % jusqu'à la fin de la décennie, avec environ 4 000 billions d'activités d'inférence par an.
À la même conférence, Inspur a présenté le système 元脑 SD200 Ultra, qui fait passer la configuration de 64 à 128 puces, avec une mémoire et un stockage d'extension jusqu'à 8 et 64 téraoctets, ainsi que la plateforme HC2000. La concurrence se déplace du processeur isolé vers le système : celui qui intègre silicium, logiciel et échelle de distribution réduit le risque de rester hors du marché.
Sources
2- 01量子位 — 阿里真武 V900 发布, T-Head SAIL 开源 (Yunqi Conference, Apsara 2026)ZH
- 02量子位 — 浪潮 AICC 2026 与 IDC 《2026 中国人工智能计算力发展评估报告》ZH
Tous les chiffres et citations de ce texte proviennent des sources citées ci-dessous.
Les contenus ont été préparés par l'équipe de rédaction, assistée par l'IA.
Sophie Leclerc
Commentaires
0- Aucun commentaire — soyez le premier.