太空中的自主AI:1080颗卫星、一台靠Claude规划的漫游车,以及一个连粪便都认不出的模型
据IEEE Spectrum 9月29日报道,NASA喷气推进实验室用Anthropic的Claude模型为“毅力号”火星车规划了两次火星行驶路线。9月25日,中国公司星图测控(STAR.VISION)发布了一个由1080艘航天器组成的计算星座。
 郑雪莉科学与健康
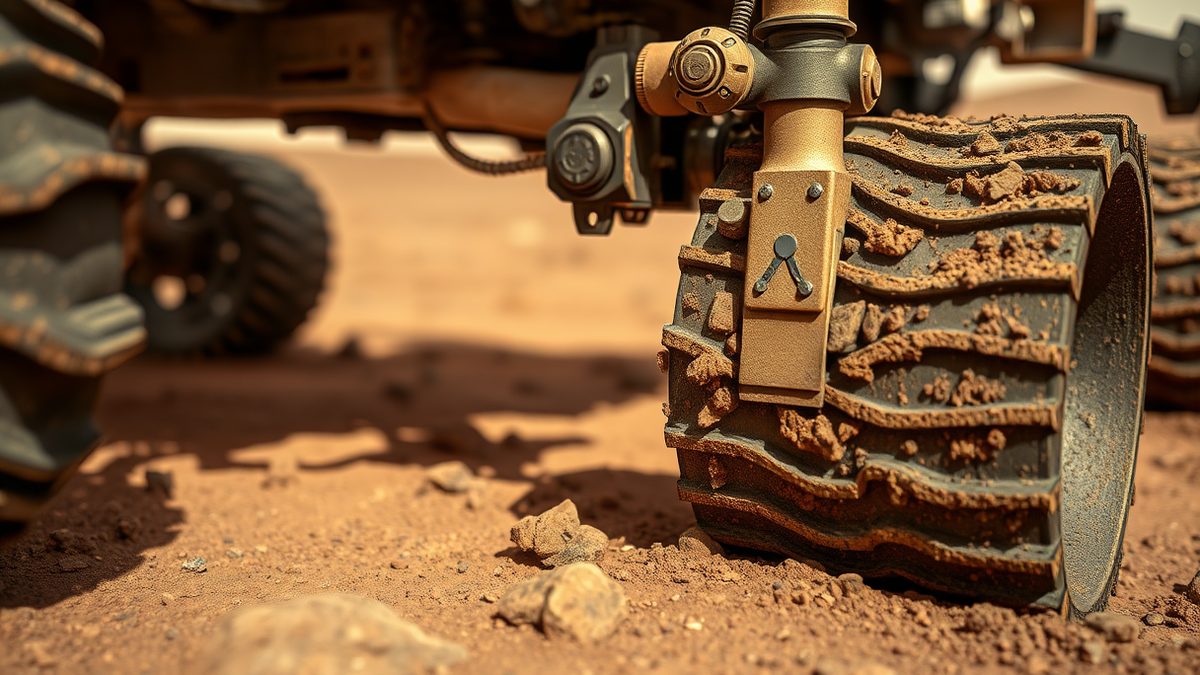
太空自主领域最新的进展不是火箭。它是在火星上由语言模型做出、经人核对后上传的一项排程决定。据IEEE Spectrum 9月29日报道,NASA喷气推进实验室用Anthropic的Claude模型协助规划“毅力号”火星车的两次火星行驶。人类规划员在发送前审查并调整了路线。
这是一次有限而克制的使用。它也是工程师们争论多年的一个转变最清楚的例子:航天器该不该自己做决定。
同一个想法上的两种截然不同的押注
据航天行业媒体china-in-space.com报道,9月25日,在全球数字贸易博览会上,中国商业航天公司星图测控(STAR.VISION Aerospace)发布了Space.IDC计算星座。数字很大。主星座约1080艘航天器,2035年前全面部署,其中约720艘用于推理任务,360艘用于通用计算。方案中有三种航天器设计。G1验证星以11.5千瓦太阳能功率提供40至60 PetaFLOPs。G2标准星以48千瓦提供160至310 PetaFLOPs。G3旗舰星以140千瓦提供460至1000 PetaFLOPs。
星图测控表示,已与中国工商银行和中国农业银行签署战略授信协议,总额100亿元人民币,按9月28日汇率约合149000万美元,其中至少10亿元可用于“第一阶段”。G1航天器的发射已预订在东方空间的引力一号和星河动力的谷神星二号上,但没有公布目标月份或季度。轨道、星间激光链路、散热器尺寸和质量均未披露,国际监管文件也尚未提交。
所以这个项目是真实的、有资金的,但仍有大量细节未定。当卖点是轨道上的算力时,这个缺口很要紧。
关于不可预测机器的老争论
IEEE Spectrum指出,工程师们让航天器自主运行已有几十年,但自主从来不是主流模式,很大程度上是因为这个领域看重行为可预测的系统。NASA软件、机器人与仿真部前主管罗伯特·安布罗斯(Robert Ambrose)向Spectrum直说了反对理由:“自主往往没有确定性的结果,这意味着你是怎样进入某种情境的,会改变行为。所以如果你从不同路径进入同一情境,结果可能不同。工程师很讨厌这一点。”
“自主往往没有确定性的结果……工程师很讨厌这一点。”
安布罗斯参与过“猎户座”飞船的自主工作和2011年上天的机器人Robonaut 2。他的观点是测试层面的,不是哲学层面的。在“猎户座”上,工程师不仅要考虑飞船可能做什么,还要考虑它可能经由哪些路径做出某个决定。Spectrum报道称,工程师找到了管理这种复杂性的办法,这正是当前这些实验得以存在的原因。
这类实验正在累积。12月,JPL用Claude完成了两次火星行驶。5月,NASA和IBM把一个压缩AI模型送上国际空间站和一颗卫星,从轨道上识别洪水和云层,被称为首个在太空演示的同类模型。7月,国际空间站上的宇航员测试了一个用于维修问答的大语言模型。这些都没有把控制权交给模型。它们都推动了边界。
这些模型实际能拿几分
如果你想对软件还有多远的路要走做一次现实检验,这里有现成的一个,尽管它与航天器毫无关系。一个名为Labqoat的博客9月29日发布了一项基准测试,把2000张野生动物痕迹照片(粪便、脚印、羽毛、蛋和骨骼各400张)交给八个模型。每个模型拿到一张照片和照片所在国家,被问是哪个物种留下的。
表现最好的模型Claude Opus 5.5在2000次中答对物种743次,即37.15%。Muse Spark 1.3以33.35%紧随其后,GPT-6 Astra为31.70%。Claude Sonnet 5.5以25.15%排第四,估计花费7.62美元,对每张照片都给出了回答,没有请求错误。在全部八个模型中,有842张照片(超过总数的40%)没有得到任何正确的物种识别。即便是Opus,也只在51.75%的照片上答对了科。
作者对结果的局限很谨慎。Sonnet、GLM和DeepSeek的分数被称为暂定,因为评分时有一个文本模型解读了部分回复,Sonnet还有15条回复待复核。蛋的照片表现最好,但作者提醒说,有些物种的照片比其他物种多。重新加权让每个物种等权后,Opus的蛋类得分从51.25%降到约37%。而且没有人类基线:没有野生动物专家试过同一套照片。博文写道:“我还不知道什么样的分数算好。”
这是一份AI基准测试的诚实版本,值得与那些轨道上的说法放在一起看。一个在给出国家作为提示的情况下、十次里有六次认不出动物痕迹的模型,显然还不足以决定卫星下一步做什么。它仍可能有助于缩小选项,再由人来核对。
钱和噪音都在哪里
天基计算已经很拥挤。china-in-space.com指出,国星宇航与之江实验室的“三体计算星座”领跑,已有十几颗卫星在轨运行。它指出,轨道晨光有重要资金支持,超智算北京科技有背景深厚的合作伙伴,两者都在运行演示卫星。国有企业正在低调推进大型计算航天器。星图测控本身至少从2023年年中起就在遥感卫星上使用AI,并表示其为乌兹别克斯坦和印度尼西亚建造的两颗卫星已验证了未来星座的部分技术。该媒体还报道,中央政府已将相关必要技术列为“十五五”规划(2026年至2030年)的重点领域。
与此同时,公众讨论并不总是技术性的。《每日邮报》9月28日发表一篇报道,称SpaceX“星舰”直播的观众在试飞进行到约7分55秒时,看到一道狭窄、略微弯曲的淡蓝色光带,尖端更白,社交媒体用户称可能是UFO。同一媒体指出,火箭进入了轨道。两篇报道都没有确认该物体是什么。
还有一个小的、有用的提醒:轨道上的自主并不是唯一在被自动化的东西。ABA Games在itch.io上发布了《Wreckfall》,一款固定屏幕的1981年风格射击游戏。在游戏里,你击中的飞行器不会消失,而是变成燃烧的残骸向下坠落,压碎沿途经过的每一架飞行器,最终落在玩家所在位置。页面附有AI披露:AI Assisted, Code。这类游戏不是科学。不过,它们相当准确地描绘了当前的技术水平:机器产出有用的东西,而人仍在决定什么算赢。
回到严肃的一面,争夺的地盘狭窄而实际。星图测控有资金,有百度智能云、微纳星空、中国科学院大学杭州高等研究院和西安电子科技大学杭州研究院等合作伙伴,还有来自浙江多个区以及西昌和崇州的若干支持函。它没有公布轨道、链路或散热方案,监管申报仍在进行中。就IEEE Spectrum而言,它报道称太空中的生成式AI仍远未可靠到可以交出航天器控制权。随着任务变得更复杂、更遥远、数量更多,工程师开始问,他们是否承担得起不去尝试的代价。
这两种立场并不矛盾,而这就是故事本身。硬件正在被融资并发射。软件正在以小步、可逆的方式测试。还没有人公布能一锤定音的那个数字:模型有多经常是对的,以及它错的时候代价是多少。
资料来源
6- 01Autonomous AI in Space Exploration Raises New StakesEN
- 02Star.vision Unveils 'Space.IDC' Computing Constellation with PartnersEN
- 03I Made AI Look at Traces. For ScienceEN
- 04Mysterious 'UFO' spotted on SpaceX livestreamEN
- 05Wreckfall: Space Invaders but they crash to earthEN
- 06Space-bunny-alpha a reasoning model from an anonymous providerEN
本文所有数字与引语均来自下列来源,未添加来源之外的内容。
本内容由编辑部在人工智能辅助下制作完成。
郑雪莉
评论
0- 还没有评论——来说两句吧。