人形机器人建厂潮撞上数据瓶颈
9月30日,Innodata开设动作捕捉实验室,为人形机器人生产训练数据。同一天,Inbolt完成1100万欧元融资,用于机器人视觉;MindOn发布一款模型,称可将推理延迟从82ms降到32ms。
 王雅琴人工智能、模型与技术
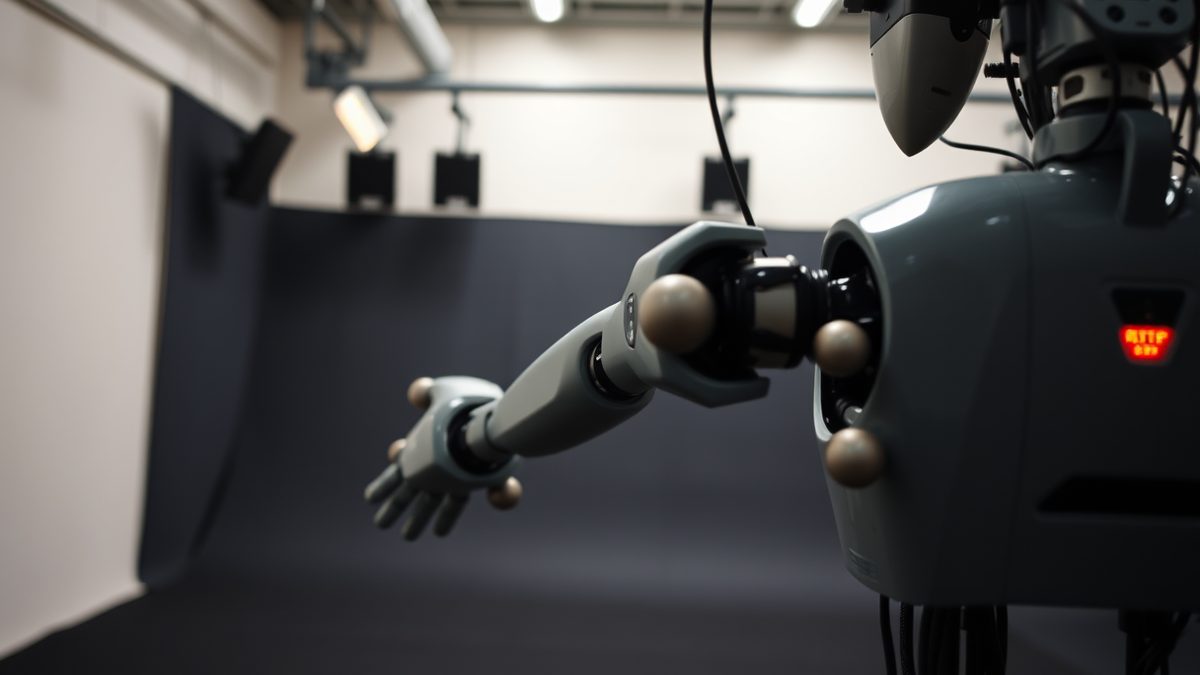
9月30日,新泽西数据工程公司Innodata开设了一间面向机器人的3D动作捕捉研发实验室。该设施将直接记录人体与机械体的运动,也会独立验证机器人内部生成的性能数据。The Robot Report在9月30日率先报道了此事。
这是一栋不大的楼,却挂着一个很大的说法。物理AI的瓶颈不在电机,不在手,也不在执行器。瓶颈在数据。
“物理AI的增长速度快于AI的任何其他细分领域,但每一支机器人团队都会撞上同一堵墙:真实世界的交互数据不够,而现有的数据生产起来又贵又慢,”Innodata首席执行官Rahul Singhal在The Robot Report报道的一份声明中说。公司称,该设施覆盖从数据采集到模型评估的全过程,将采集人形机器人、遥操作硬件、可穿戴系统、传感器装置以及Universal Manipulator Interface夹爪的动作数据。Innodata成立于1988年。它的论点是:大语言模型吃的是开放互联网,而机器人在物理世界没有对应的语料库。公司机器人与物理AI副总裁Franklin Tanner对The Robot Report说,物理AI“必须一次一次交互地挣来自己的token”。Tanner还反驳了基于推理的动作捕捉方案。他说,“直接3D动作捕捉无可替代”。靠2D像素工作的计算机视觉模型难免出错。他说,实验室的传感器就是为记录每个关节最细微的动作而设计的。
这个论点并不新鲜。不过,它现在开始拿到钱了。
同样在9月30日,总部位于巴黎的Inbolt表示已融资1100万欧元,用于拓展国际市场,并进入数据中心和电子制造领域,Tech.eu报道。新投资方Shift4Good领投,Bridges Climate Transition Partners以及现有投资方BNP Paribas Developpement和Ora Global参投。公司累计融资额达到3000万欧元。Inbolt由Rudy Cohen、Albane Dersy和Louis Dumas于2019年创立,销售一套与硬件无关的AI软件层,并搭配3D视觉。当零件来料位置不正或工装磨损时,系统让机器人实时调整控制回路。据Tech.eu,这套系统运行在三大洲100多家工厂的200多台机器人上。客户包括Bosch、Beko、Flex、Ford、Stellantis和Toyota。公司的卖点是:工厂可以升级现有产线,而不必更换产线。
还有速度。MindOn在9月30日发布技术文章,介绍Mind-1模型,称它能把机器人执行任务的节拍带到人类水平。公司报告称推理延迟从82ms降到32ms。它推算,当末端执行器速度为每秒3米时,10ms的延迟大约对应3cm的位移,足以让精确抓取或插入失败。MindOn还点出一个不那么显眼的问题:大量机器人操作数据来自遥操作,而遥操作比人的自然动作慢。模型在学习任务的同时,也学会了示范动作的节奏。
三条消息,一天之内,同一个前提。能力演示不再是难的那部分。
Fig Inc.同样在9月30日发布的一份技术报告,把这个图景往有用的方向搅复杂了。研究者Yangyue Wang、Harshvardhan Sikka、Pranav Guruprasad和Sudipta Chowdhury评估了包括Astra和Opus 5.5在内的前沿模型,覆盖网页自动化以及四个物理领域:Bench2Drive、VLABench、IndEgo和Assembly101。他们发现,基准平均分会掩盖巨大的任务级差异。在他们测试的每一对模型里,较弱的模型至少有一项任务是较强的模型没做出来的。一次模型更新可能让平均分几乎不动,却把许多单项任务的结果翻了个面。他们公开了一个叫RIDGE的数据集,里面有逐项结果和模型轨迹。
把这份报告和工厂那边的数字放在一起看,图景又变了。
这一切的背景,是一个已经高度自动化、但大多不是人形的制造业基础。据近期行业报道汇总,目前全球工厂里有超过3000万台机器人,其中人形机器人只有数千台。同一批报道提到,中国的优必选在9月开设了一家工厂,宣称产能为每十分钟一台人形机器人。报道还提到,Hyundai一直在扩大Atlas的生产和部署,同时在其佐治亚州工厂开设培训中心。TechRadar在9月30日报道,日本希望到2040年拥有1000万台AI机器人。据Korea JoongAng Daily,韩国的SFA与Rainbow Robotics签署谅解备忘录,推动到2030年实现无人化工厂。
这轮建设里并非每台机器人都是人形。Mark Cuban认为人形机器人十年内会失败,他近日重申了这一立场。IEEE Spectrum刊登了机器人专家对Tesla的Optimus的评估。Tesla自己的供应链在别处也承压。9月30日,Electrek报道,Tesla计划中的得克萨斯太阳能工厂被卷入中国设备商Linton Crystal Technologies与浙江晶盛机电之间的美国专利诉讼。诉讼涉及Tesla太阳能计划中长晶环节所需的直拉法单晶炉。Tesla并非该案当事方。
这条消息在这里有意义,是出于一个结构性原因。人形机器人的供应链和太阳能供应链并不是同一条。但失效模式是一样的:一个专用部件,来自少数几家供应商,卡在一条很长的生产计划的最前端。
话题由此回到数据。Innodata的Tanner给The Robot Report举了一个具体例子,说明为什么上下文难以编码。一台被要求拿起杯子的机器人,可以抓杯柄,也可以抓杯身。两者在机械上都成立,但如果杯子里是热水,其中一种会烫到手。这类区别在现有数据集里很少出现。Inbolt的客户在真实生产中面对的是相关问题。一个位置不正的零件可以让机器人停住,也可以产出次品,而代价体现为停机,不是一次失败的演示。MindOn的延迟算术是同一件事的第三面:在速度之下,微小的感知和控制误差不再微小。
钱也在跟着动。Inbolt的1100万欧元放在涌向人形硬件的资本旁边并不算多,但它瞄准的是存量设备,不是新造的人形机器人。Innodata卖的是测量和评估,不是机器人。The Robot Report的母公司Arrowfly在9月30日上线了一个AI for Engineers平台,面向的正是这群一线从业者。它提到,其组合内已有超过3万名工程专业人士在关注AI话题,有210万经过核实的行业读者,并计划于2027年9月20日至22日在内华达州Henderson举办一场会议。这是一门媒体生意,不是机器人生意,但它能相当合理地反映注意力和预算流向哪里。
有一个前提值得直说。目前宣布的人形机器人工厂产能,大部分是产能,不是产量。名字、日期和台数目标传播得比实际出货快。工厂开业到满负荷运转之间的差距,通常以季度计,有时以年计。目前没有任何人形机器人产线有经过核实的产量数据,也不应从公布的产能里推断出产量。
过去三天发布的八个信源指向同一件事:市场正从不同方向汇聚到同一个诊断上。Innodata想卖训练数据。Inbolt想卖感知层,让现有机械臂应付各种变化。MindOn想卖速度。Fig的研究者想卖一个更诚实的基准。没有一家在卖机器人。
资料来源
8- 01Innodata opens motion-capture lab to help humanoids move more like peopleEN
- 02Inbolt raises €11M to bring real-time vision and intelligence to industrial robotsEN
- 03Mind-1: Cutting robot inference latency from 82ms to 32msEN
- 04How Do Astra and Opus 5.5 Perform on Robotics and Web TasksEN
- 05The Robot Report parent Arrowfly launches AI for Engineers platform, events for engineers navigating AIEN
- 06Tesla's solar factory dragged into patent war between Chinese suppliersEN
- 07Tesla Robotaxi fleets are the new crypto treasury for zombie companiesEN
- 08What 30k robot dogs taught me about degrees of freedom, shipping a real productEN
本文所有数字与引语均来自下列来源,未添加来源之外的内容。
本内容由编辑部在人工智能辅助下制作完成。
王雅琴
评论
0- 还没有评论——来说两句吧。