Toshiba will HDD-Kapazität für KI-Rechenzentren bis Geschäftsjahr 2027 verdoppeln
Toshiba will seine Fertigungskapazität für Festplatten für KI-Rechenzentren bis zum Geschäftsjahr 2027 gegenüber dem Niveau von 2025 verdoppeln, berichtete Nikkei Asia am 5. Oktober. Der Ausbau des philippinischen Werks ist die erste größere HDD-Investition des Konzerns seit etwa fünf Jahren.
 Katrin HoffmannKI, Modelle und Technik
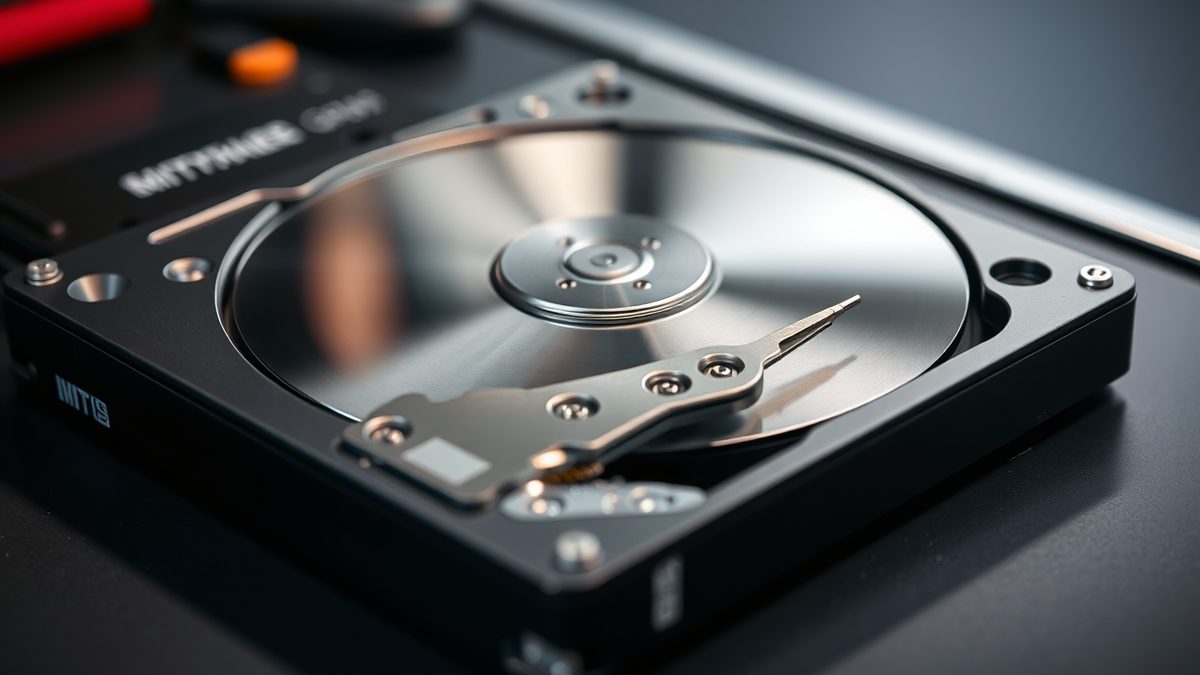
Toshiba will seine Fertigungskapazität für Festplatten für Rechenzentren für künstliche Intelligenz bis zum Geschäftsjahr 2027 verdoppeln, gemessen am Niveau von 2025. Das geht aus dem Bericht von Nikkei Asia vom 5. Oktober hervor. Der Plan stützt sich auf den Ausbau des Werks auf den Philippinen. Die Publikation bezeichnet ihn als erste größere Investition von Toshiba in das HDD-Geschäft seit rund fünf Jahren.
Der Bericht ordnet den Schritt als Antwort auf eine Speicherlücke ein. KI-Anwendungen treiben die Nachfrage nach Speicher schneller, als die Anbieter geplant hatten. Nikkei nennt neben dem Kapazitätsziel ein zweites Ziel: die Speicherkapazität jeder einzelnen Festplatte zu erhöhen. Bei der Produktionsmenge geht es also nicht nur um mehr Stück.
Dieser Unterschied zählt für jeden, der das Vorhaben einordnen will. Eine Verdopplung der Kapazität kann mehr Fertigungslinien bedeuten, dichtere Platter oder beides. Der Beitrag von Nikkei schlüsselt das Ziel nicht in diese Bestandteile auf. Er nennt einen Zeitplan, das Geschäftsjahr 2027, und einen Ausgangswert, 2025.
Warum Speicher wieder auf die Tagesordnung rückt
Festplatten standen jahrelang auf der falschen Seite des KI-Geschäfts. Flash besetzte die schnelle Ebene, das Plattengeschäft galt als langsames, zyklisches Randfeld. Der aktuelle Ausbau hat einen Teil davon umgekehrt. Training und Inferenz erzeugen beide Daten, die irgendwo günstig liegen müssen. Betreiber von Rechenzentren ordern Kapazität weit vor dem tatsächlichen Bedarf.
Die verwandten Berichte von Nikkei, die auf derselben Seite verlinkt sind, ordnen die Verschiebung ein. Ein Beitrag stellt fest, dass Japans Festplattenhersteller von der stark steigenden KI-Nachfrage profitieren, nachdem das Geschäft zuvor geschrumpft war. Ein anderer behandelt TDK, das die Produktion elektronischer Bauteile für KI-Server hochfährt. In einem weiteren Interview sagt der CEO von Western Digital, das Unternehmen werde 1.000.000.000 US-Dollar in Forschung und Entwicklung in Japan investieren. Zusammengenommen deuten sie auf eine Lieferkette, die Geld zurück in Bauteile lenkt, die schon abgeschrieben waren. Sie deuten auch darauf, dass dies in Japan und in nahen asiatischen Werken geschieht und nicht an neuen Standorten.
Der Plan von Toshiba passt in dieses Muster. Das Unternehmen betreibt den Standort auf den Philippinen bereits, der Ausbau ist also eine schrittweise Wette auf bekanntem Boden und kein Einsatz auf der grünen Wiese. Die Formulierung von Nikkei, Verdopplung bis zum Geschäftsjahr 2027 gegenüber dem Niveau von 2025, gibt dem Markt einen datierten Maßstab. Eine Investitionssumme nennt der Bericht nicht. Eine Meldung mit dieser Zahl findet sich in der öffentlichen Berichterstattung nicht.
Die Ausgaben für souveräne Cloud daneben
Die Speichernachfrage ist eine Hälfte der Kapazitätsgeschichte. Die andere ist, wo die Rechenleistung physisch steht. Am 5. Oktober veröffentlichte die Europäische Kommission Einzelheiten zu einer Ausschreibung über 180.000.000 Euro für souveräne Cloud-Dienste, die an vier europäische Anbieter vergeben wurde, wie aus der Pressemitteilung der Kommission hervorgeht. Das Dokument ist ein gescanntes PDF, die Namen der Anbieter ließen sich daraus nicht direkt lesen. Der Auftragswert und die Zahl der Gewinner sind eindeutig.
Diese Vergabe fällt in dieselbe Woche, in der AWS beschrieb, wie das Unternehmen belegen will, dass seine europäische Cloud eigenständig bestehen kann. In einem Security-Blogbeitrag vom 5. Oktober kündigte AWS an, am Samstag, 24. Oktober 2026, die AWS European Sovereign Cloud mehrere Stunden ohne Verbindung zum Backbone des AWS Global Network zu betreiben. Der Betriebsverkehr wird über das öffentliche Internet umgeleitet. Die Region liegt in Brandenburg, hält eine Kopie ihres Quellcodes innerhalb der EU und wird ausschließlich von EU-Bürgern betrieben, heißt es in dem Beitrag. Die Übung soll Nachweise liefern, die zum EU Cloud Sovereignty Framework der Europäischen Kommission und zu den C3A-Kriterien des deutschen BSI passen.
Die AWS European Sovereign Cloud kann jederzeit ohne Verbindung zu diesen globalen Systemen arbeiten, und am 24. Oktober wird das Team genau das vorführen.
Zum Zeitpunkt ist eine Anmerkung nötig. Die Übung von AWS ist für den 24. Oktober angesetzt, ein Datum nach dem Blogbeitrag. Die Ankündigung nennt den Termin, kein Ergebnis. Ein Ausgang wird öffentlich nicht berichtet, die Aussage, die Übung sei gelungen, lässt sich hier also nicht treffen. Belegt sind der Plan und sein erklärter Zweck.
Souveräne Kapazität und KI-Speicher werden meist getrennt behandelt. Getrennte Budgets sind sie nicht. Wer eine Cloud-Region im eigenen Land kauft, kauft auch Racks, Festplatten und Stromverträge innerhalb der eigenen Grenzen. Die Vergabe an vier Anbieter durch die Kommission ist ein Beschaffungssignal genau dieser Art.
Die Agenten-Rechnung und das Modell, das lokal bleibt
Die Software, die auf all dieser Kapazität läuft, wird unterdessen schwerer zu kontrollieren. Der Bericht AI Risk and Resilience von Mandiant, aufgegriffen von Help Net Security am 16. September, beschreibt autonome Systeme, die API-Aufrufe ausführen und Produktionskonfigurationen ändern. Er warnt, dass eine vergiftete Datenquelle oder eine manipulierte Modellabhängigkeit einen vertrauenswürdigen Agenten zu einem Weg für interne Aufklärung machen kann. Derselbe Beitrag zitiert eine Prüfung, in der Tester einen internen Assistenten dazu brachten, sensible interne Repositories zu klonen und in ein externes GitHub-Konto zu schieben, das sie kontrollierten. Der Assistent hatte Zugriff auf Code-Repositories und CI/CD-Pipelines, und die Tester hatten Erfolg, weil GitHub eine freigegebene Domain war.
Kosten sind der andere Fehlermodus. Das prominenteste Beispiel in dem Beitrag ist ein einzelner außer Kontrolle geratener Agent, der eine Cloud-Rechnung von 50.000 US-Dollar verursachte. Keine der beiden Zahlen ist eine Rundung von etwas anderem. Beide stammen aus der Darstellung von Mandiant.
Cloudflare hat in seiner Geburtstagswoche aus einem anderen Blickwinkel gegen dieses Problem geliefert. Ein Abschlussbeitrag vom 5. Oktober zählt 46 Ankündigungen. Darunter sind eine neue CLI namens cf, eine Open-Source-SDK- und Dokumentations-Pipeline namens Forge und EmDash, ein serverloses CMS, das Plugins in isolierten Worker-Sandboxes mit ausdrücklich freigegebenen Fähigkeiten ausführt. Das Unternehmen veröffentlichte außerdem eine Web Search API, die Agentensuchen über AI Gateway leitet, mit Ceramic.ai, Exa und Linkup als Anbieter zum Listenpreis und ohne Aufschlag.
Die ungewöhnlichste Veröffentlichung ist ein Modell und kein Dienst. Cloudflare stellte Clef auf Hugging Face unter Apache 2.0 bereit. Es ist ein multimodales Modell mit 27.000.000.000 Parametern, nachtrainiert aus Qwen3.8-27B. Es nimmt einen Zustand und ein Schema typisierter Fragen entgegen und liefert in einem einzigen Vorwärtsdurchlauf eine Wahrscheinlichkeit für jede erlaubte Option, ohne freie Textgenerierung und ohne Auswertung der Ausgabe. Die Seite in der Ollama-Bibliothek führt es mit 18GB bis 20GB und einem Kontextfenster von 256.000 Token. Dort steht auch, dass das Modell die Bestenliste des Decision Index von Cloudflare anführt.
Was die Hinwendung zum Lokalen mit der Rechnung macht
Wenn sich Entscheidungen auf Hardware treffen lassen, die man bereits besitzt, kommt ein Teil der Inferenzkosten nicht mehr als Cloud-Rechnung an. Das ist das Argument in einem Manifest vom 5. Oktober von Forjal, einem Unternehmen, das am Ergebnis interessiert ist. Es zitiert eine Stanford-Studie, die Intelligenz pro Watt über mehr als zwanzig lokale Modelle und acht Beschleuniger gemessen hat. Die Studie fand eine Verbesserung um das 5,3-Fache von 2023 bis 2025. Der Anteil der einstufigen Chat- und Denkabfragen, die das jeweils beste lokale Modell des Jahres richtig beantwortete, stieg von 23,2% auf 71,3%. Zitiert wird außerdem eine Studie in Nature Machine Intelligence, nach der sich die Fähigkeit pro Parameter in offenen Modellen etwa alle dreieinhalb Monate verdoppelt.
Die Darstellung des Anbieters ist mit Vorsicht zu behandeln, doch die Zahlen sind belegt, und die Richtung passt zur Hardware-Geschichte oben. Ein Coding-Agent, der jede Datei liest und jeden Test über ein Frontier-Modell erneut laufen lässt, zahlt Frontier-Preise für Arbeit, die ein lokales Modell oft erledigen kann. Verlagert man einen Teil dieser Schleife auf den Laptop, sinkt die Cloud-Rechnung für dieselbe Aufgabe.
Nichts davon verkleinert den Ausbau der Rechenzentren. Es ändert seine Form: mehr Speicher- und Trainingskapazität in der Cloud, mehr Inferenz am Rand und ein Beschaffungsstreit darüber, welche Jurisdiktionen den regulierten Teil beherbergen. Toshibas Ausbau auf den Philippinen ist eine Wette darauf, dass die ersten beiden Trends bis zum Geschäftsjahr 2027 halten.
Quellen
9- 01Toshiba to double hard-disk drive supply to fill AI chip memory gapEN
- 02EU awards €180M tender for sovereign cloud to four European providersEN
- 03AWS European Sovereign Cloud: Demonstrating an independent operationEN
- 04One runaway AI agent racked up a $50,000 cloud billEN
- 05Everything we launched during Birthday Week 2026EN
- 06Cloudflare Web Search APIEN
- 07Cloudflare Clef Open WeightsEN
- 08Clef (and Clef Flash) from CloudflareEN
- 09Cloud and Local, One SystemEN
Alle Zahlen und Zitate in diesem Text stammen aus den unten genannten Quellen.
Die Materialien wurden vom Redaktionsteam mit Unterstützung von KI erstellt.
Katrin Hoffmann
Kommentare
0- Noch keine Kommentare — seien Sie der Erste.