Niedobór akceleratorów AI przeniósł się na 90-procentowy monopol w tkaninie szklanej
Japońska firma Nittobo kontroluje około 90% światowych dostaw specjalistycznej tkaniny z włókna szklanego, która wchodzi do każdej zaawansowanej obudowy układu AI. Nowe moce produkcyjne trafią na rynek dopiero w połowie 2027 roku.
 Anna KaczmarekAI, modele i technologie
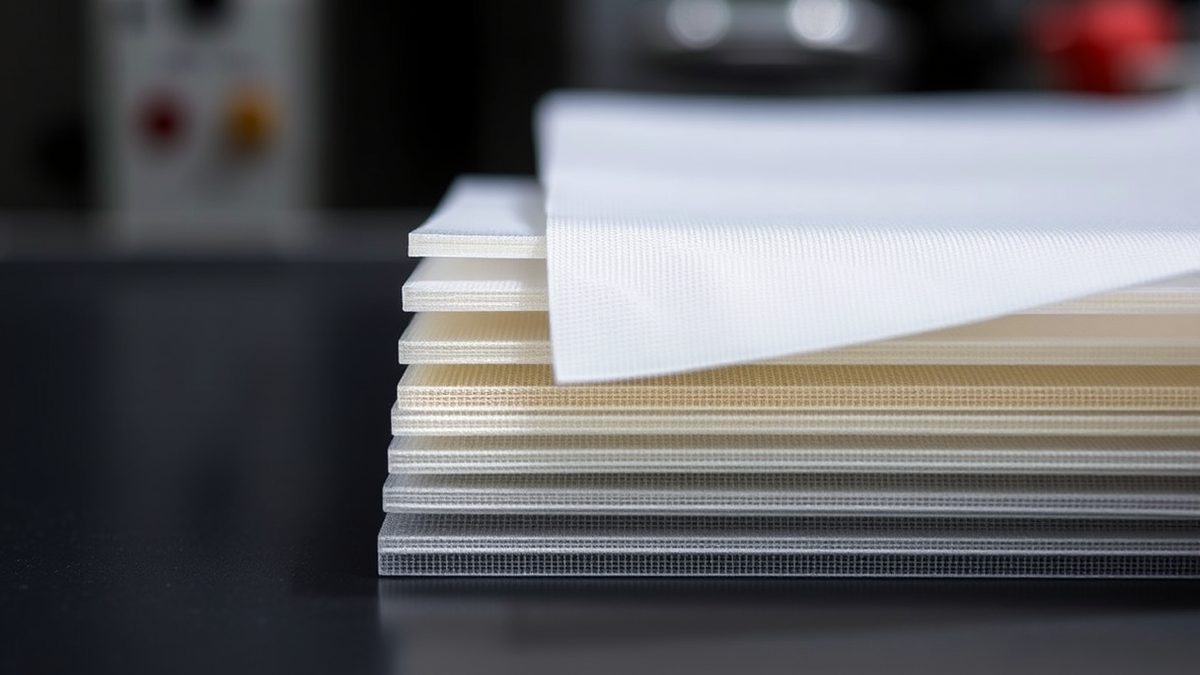
T-glass od Nittobo to tkanina szklana o niskim współczynniku rozszerzalności cieplnej (CTE), używana w organicznym rdzeniu podłoży IC, czyli w warstwie łączącej układ z płytką drukowaną. Utrzymuje wymiary dużych, mocno grzejących się obudów, a to znaczy coraz więcej, bo procesory AI rosną i pracują w wyższych temperaturach. Tom's Hardware poinformował 9 marca, że materiał wchodzi do każdej zaawansowanej obudowy układu AI.
Ceny wzrosły o 20 do 30%. Terminy dostaw materiałów w dalszej części łańcucha, takich jak laminaty miedziane, wydłużyły się z normalnych 8 do 10 tygodni do ponad 20.
„Przy jeszcze bardziej ograniczonych dostawach T-glass dostawcy nie podają już terminów realizacji”, powiedział Bill Ho, analityk w Yuanta, cytowany przez Tom's Hardware.
Obejście tego wąskiego gardła nie jest łatwe. Bilal Hachemi, analityk w Yole Group, który śledzi łańcuch dostaw podłoży IC, powiedział Tom's Hardware, że T-glass „ma określone wartości przenikalności dielektrycznej i CTE, które lepiej sprawdzają się w układach AI, zwłaszcza w organicznym rdzeniu”. Tańszy E-glass trafia do słabszych układów, takich jak mikrokontrolery i starsze procesory mobilne. Przy dużych pakietach 2.5D i 3D, a więc przy zaawansowanych akceleratorach AI, wybierany jest T-glass.
Nittobo potraja moce w zakładzie w Fukushimie w Japonii, ale według Tom's Hardware nowe dostawy pojawią się na rynku dopiero w połowie 2027 roku. Nowych linii nie uruchamia się z dnia na dzień: materiał wymaga specjalistycznych elektrycznych pieców topiących, pracujących w temperaturze od 1 600 do 1 700 stopni Celsjusza. Proces obejmuje topienie szkła bogatego w krzemionkę, przędzenie go w przędzę i tkanie w ultracienką tkaninę. Hachemi wskazał też na niskie marże w branży: „każdy wzrost popytu na materiały build-up, materiał ABF czy T-glass może wywołać niedobór, bo to stoi w sprzeczności z podstawami tej branży”.
Większe obudowy, więcej tkaniny
Hiperprocesorzy zamawiają coraz większe obudowy układów, a każda zużywa więcej T-glassu. Według danych Nvidii, na które powołuje się Tom's Hardware, rozmiary interposerów wzrosły z 814mm2 w architekturze Hopper do 1 700mm2 w Blackwell, czyli o 109%, a nadchodzące generacje Rubin i Feynman pójdą dalej. Bank of America szacuje, że segment materiałów elektronicznych Nittobo niemal podwoi sprzedaż z 40,9 mld jenów (266 mln dolarów) w 2025 roku do 87,7 mld jenów do marca 2028 roku, przy marży operacyjnej zbliżającej się do 48%.
„Popyt na tkaninę T-glass prawdopodobnie wzrośnie bardziej, niż pierwotnie oczekiwano”, powiedział Takashi Enomoto, analityk badawczy w Bank of America, cytowany przez Tom's Hardware. „Skupiano się na wzroście popytu na gruby T-glass do półprzewodnikowych pakietów GPU i CPU, ale teraz popyt na ultracienki T-glass prawdopodobnie wzrośnie za sprawą przejścia z E-glass na ultracienki T-glass w urządzeniach najnowszej generacji”.
Wyścig o przydział mocy produkcyjnych dał już nietypowy widok. Hachemi powiedział Tom's Hardware, że bezpośredni kontakt Nvidii z dostawcą materiału na wcześniejszym etapie łańcucha jest w tej jego części bez precedensu. „Po raz pierwszy widzimy, jak Nvidia, klient końcowy, zwraca się do dostawców materiałów wyżej w łańcuchu, żeby zabezpieczyć moce i mieć pewność, że je dostanie”, powiedział. Ryzyko polega na tym, że gdy Nvidia zablokuje swoją część, konkurencyjni kupcy układów zostaną z walką o resztę.
Nittobo nie stawia tylko na Fukushimę. Podwaja moce produkcji surowej przędzy w zakładzie na Tajwanie i importuje przędzę z powrotem do Japonii, gdzie powstaje tkanina. Firma zawarła też umowę o współpracy z Nanya Plastics, której zleca część tkania; według Tom's Hardware do 2027 roku około 20% tkaniny szklanej Nittobo ma tkać Nanya. Współpraca z jednym z największych konkurentów dobrze pokazuje, jak napięty stał się rynek.
Szeroki rynek akceleratorów nie stoi w miejscu. Microsoft Maia 200, przedstawiona na Hot Chips 2026, powstaje w technologii TSMC 3nm, ma 750 watów TDP, 7TB/s przepustowości HBM w 6 stosach HBM oraz 10 000 TFLOPS wydajności FP4, według relacji ServeTheHome z sesji. Te obudowy nadal potrzebują materiału podłożowego, który potrafi wytworzyć tylko garstka dostawców.
Nvidia tymczasem wciska AI głębiej we własny proces projektowania. Tim Costa, wiceprezes i dyrektor generalny ds. inżynierii obliczeniowej w Nvidii, powiedział dziennikarzom, że AI i obliczenia przyspieszane przechodzą „od narzędzi produktywności do podstawowej infrastruktury inżynierskiej”, jak 27 lipca podał The Next Platform. Cadence twierdzi, że jej AI Super Agents potrafią skrócić cykle walidacji RTL 40 razy, a Synopsys mówi, że jego przepływ agentowy dostarcza zwalidowany RTL 50 razy szybciej niż inne platformy.
Nic z tego nie skraca kolejki po T-glass. Niedobór podłoży przypomina, że rozbudowa AI zależy od materiałów, o których mało kto słyszał, produkowanych przez firmy niemające prawie żadnej konkurencji.
Źródła
3- 01Shortages of crucial chip packaging material threatens AI accelerator supply chainsEN
- 02Microsoft's Maia 200 AI Accelerator at Hot Chips 2026EN
- 03Nvidia Accelerates Chip Engineering With AI AgentsEN
Wszystkie liczby i cytaty w tym tekście pochodzą z poniższych źródeł. Nie dopisujemy danych, których w źródłach nie ma.
Materiały zostały przygotowane przez zespół redakcyjny wspierane przez AI.
Anna Kaczmarek
Komentarze
0- Brak komentarzy — bądź pierwszy.