Cour suprême des États-Unis : une œuvre entièrement générée par IA n'a pas d'auteur. Le litige continue
Le refus d'examiner l'affaire de Stephen Thaler clôt le volet de l'auteur-machine, mais déplace le débat vers l'entraînement sur des données d'autrui, où l'omnibus européen sur les données change les règles.
 Lucas PetitOpinions et commentaires
Thèse : l'absence de protection pour les œuvres entièrement générées par IA est cohérente, mais ne tranche rien sur la valeur du marché. Le vrai litige se déplace plus haut : l'entraînement sur la création d'autrui est-il légal ? Sur ce point, les États-Unis et la Chine jugent en sens opposé.
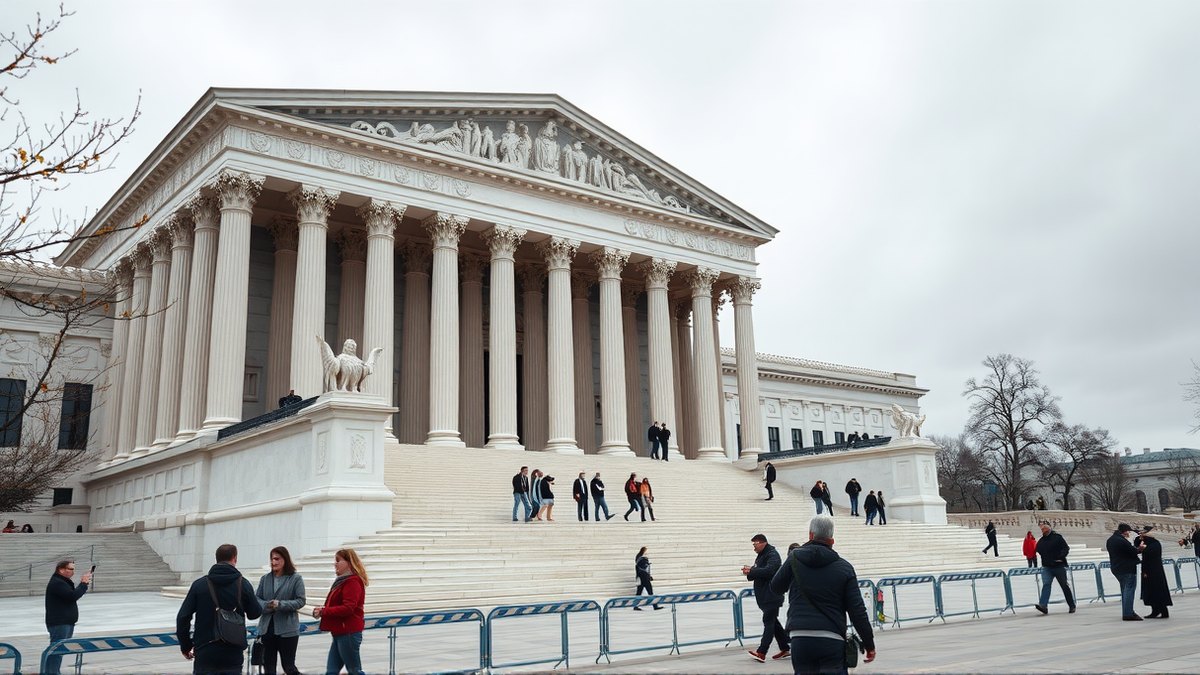
Le 2 mars 2026, la Cour suprême des États-Unis a refusé d'examiner l'appel du chercheur Stephen Thaler, qui réclame des droits d'auteur sur une image générée par son système d'IA. Thaler avait déposé sa demande d'enregistrement pour l'œuvre « A Recent Entrance to Paradise » dès 2018. Il avait déjà perdu devant l'office du droit d'auteur, qui a jugé en 2022 que la création doit avoir un « auteur humain ». Un juge fédéral à Washington a qualifié en 2023 l'auteur humain d'« exigence fondamentale » de la protection. La cour d'appel du district de Columbia a confirmé cette décision en 2025.
La décision ferme le dossier, mais ne met pas fin au débat, pour deux raisons. L'office a d'abord refusé d'enregistrer aussi des images issues de Midjourney lorsque leurs auteurs invoquaient une « co-création avec l'IA ». La ligne est claire : sans humain, pas de droit. La génération entièrement par IA reste ensuite une marge du marché. La valeur se crée du côté des données d'entraînement, pas du résultat.
C'est là qu'apparaît un écart que personne à Washington ne tranchera. Un tribunal chinois à Wuhan a jugé que l'auteur d'un contenu généré par IA peut détenir des droits d'auteur s'il a contrôlé et prévu le résultat en écrivant le prompt et en choisissant les paramètres. C'est la première affaire de ce type dans cette ville. La doctrine est opposée à l'américaine : ce qui compte n'est pas qui a dessiné les pixels, mais qui a maîtrisé le processus. Les deux plus grands marchés de l'IA partent donc de deux définitions différentes de l'auteur. Ils devront un jour clarifier ce que cela signifie pour les œuvres qui franchissent les frontières.
L'Union européenne tranche le même problème ailleurs, dans le droit de la protection des données. Le compromis de la présidence irlandaise du 3 septembre 2026, révélé par Politico, rétablit l'idée de considérer par défaut l'usage de données personnelles pour l'entraînement d'une IA comme un « intérêt légitime ». L'Allemagne aurait plaidé pour cette solution, en arguant qu'elle aiderait les entreprises européennes. Max Schrems, de noyb, qualifie cela de « dépossession numérique des Européens » et la mesure d'« ouverture totale des données européennes aux groupes mondiaux ».
Trois modèles se dessinent donc. L'américain, où la protection exige un humain et où la décision lui revient : les entreprises poursuivies l'ont d'ailleurs admis, reconnaissant avoir entraîné leurs systèmes sur des contenus protégés. Le chinois, où compte le contrôle du processus. Et l'européen, qui, au lieu de trancher sur l'auteur, tente d'ouvrir largement les données d'entrée. Trois philosophies du droit dans une même chaîne de valeur mondiale, c'est une recette pour l'arbitrage réglementaire. Les entreprises entraîneront là où c'est le moins cher et vendront là où c'est le plus cher, à condition que les tribunaux suivent la technologie.
Sources
3- 01美国最高法院一锤定音,AI 作品不受版权保护ZH
- 02全国首例 AI 生成图著作权案在武汉判决ZH
- 03"Digitale Enteignung": Datenschützer warnen vor Pauschalerlaubnis für KI-TrainingDE
Tous les chiffres et citations de ce texte proviennent des sources citées ci-dessous.
Les contenus ont été préparés par l'équipe de rédaction, assistée par l'IA.
Lucas Petit
Commentaires
0- Aucun commentaire — soyez le premier.