DAMO RADAR:一个模型在腹部18个器官中识别146种疾病
这个面向医学影像的通用模型于2026年9月18日发表在《Science》杂志上。近4万例检查的平均AUC为0.913,算法和权重已全部公开。
 郑雪莉科学与健康
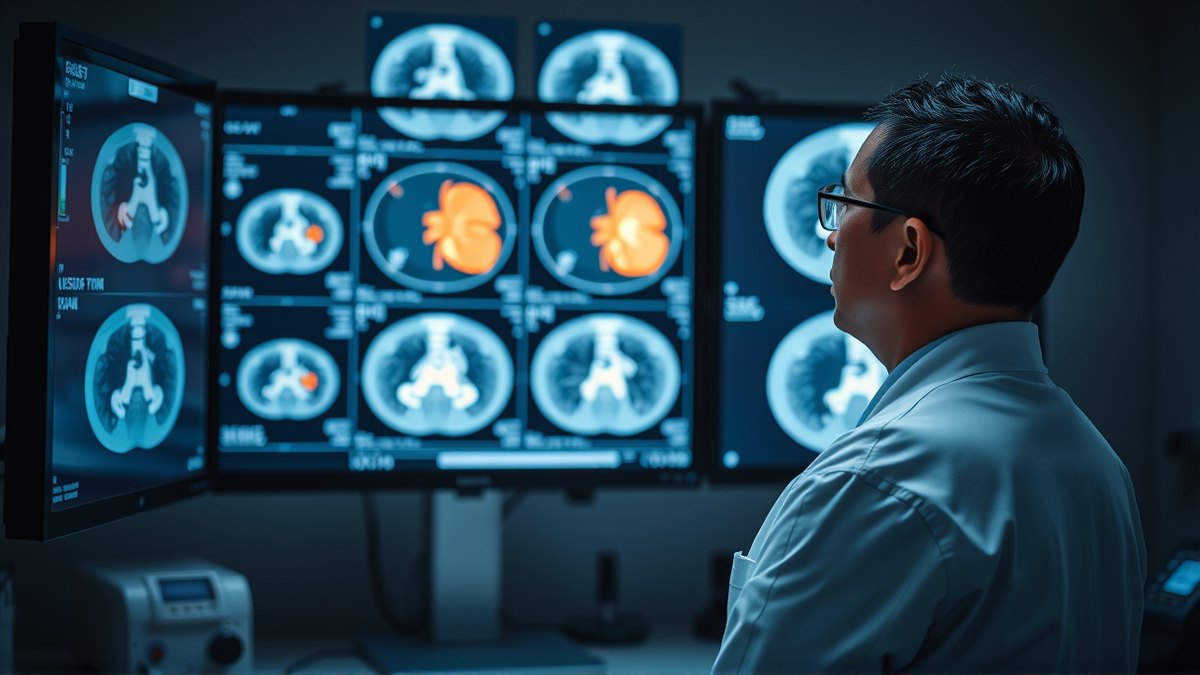
阿里巴巴达摩院与浙江大学医学院附属第一医院于2026年9月18日在《Science》杂志上发表了DAMO RADAR模型。这是一个通用的医学影像模型。单一系统基于增强CT检查,在腹部18个解剖器官中识别146种疾病。
此前的医学影像走的是“一种疾病,一个模型”的路线。肺结节、胰腺癌、糖尿病视网膜病变,各有各的工具。达摩院称,这类模型“在很大程度上依赖人工标注,成本高昂,针对一种疾病的训练通常需要两年,而且训练完成后无法泛化到其他疾病”。通用模型要减少这种依赖。
RADAR面对的任务并不轻松。一次CT检查包含数百个断层,腹部器官相互重叠、密度相近,病变信号往往非常细微。模型同时学习图像和语言:影像数据与诊断报告中的描述相结合。机制先识别器官,比如肝脏、胰腺、消化道,再把它与报告中的描述对应起来。这样就不会被正常组织的背景干扰。
与医生相比表现如何
评估覆盖18个器官和146种疾病。在近4万例真实检查中,平均AUC为0.913。AUC衡量的是区分患病与健康者的能力,1.0为理想结果。为了把模型与人比较,团队邀请了来自14个中心的26名放射科医生:11名经验丰富,15名资历较浅。医生和模型评估了300名患者的CT检查。平均而言,RADAR的表现优于26名医生中的23名。只有三名经验丰富的放射科医生取得了略高于模型的结果。
在人机协作测试中,模型的提示把疾病识别的灵敏度提高了约10个百分点,阅读单个病例的平均时间缩短了30.7个百分点。在部分测试中,使用AI提示的年轻放射科医生,灵敏度高于没有支持的年长同事。
达摩院把通用模型比作导航。它不会代替医生做出最终诊断,只是指出可能的疾病和容易遗漏的区域。“专用模型的核心是高精度,通用模型的核心是广泛覆盖,”公司表示,并补充说两条路线并不竞争,而是在不同的临床场景中各自发挥作用。
算法代码和模型权重已全部公开,供全球医学和科学界使用。不过,发表本身并不等于落地。真正的价值,将由后续在其他医院和不同于训练人群中的测试来决定。
资料来源
2本文所有数字与引语均来自下列来源,未添加来源之外的内容。
本内容由编辑部在人工智能辅助下制作完成。
郑雪莉
评论
0- 还没有评论——来说两句吧。