DAMO RADAR : un seul modèle reconnaît 146 maladies dans 18 organes de l'abdomen
Un modèle général chinois d'imagerie médicale a été décrit le 18 septembre 2026 dans la revue Science. L'AUC moyenne sur près de 40 000 examens atteint 0,913, et l'algorithme comme les poids ont été rendus publics.
 Amélie BernardScience et santé
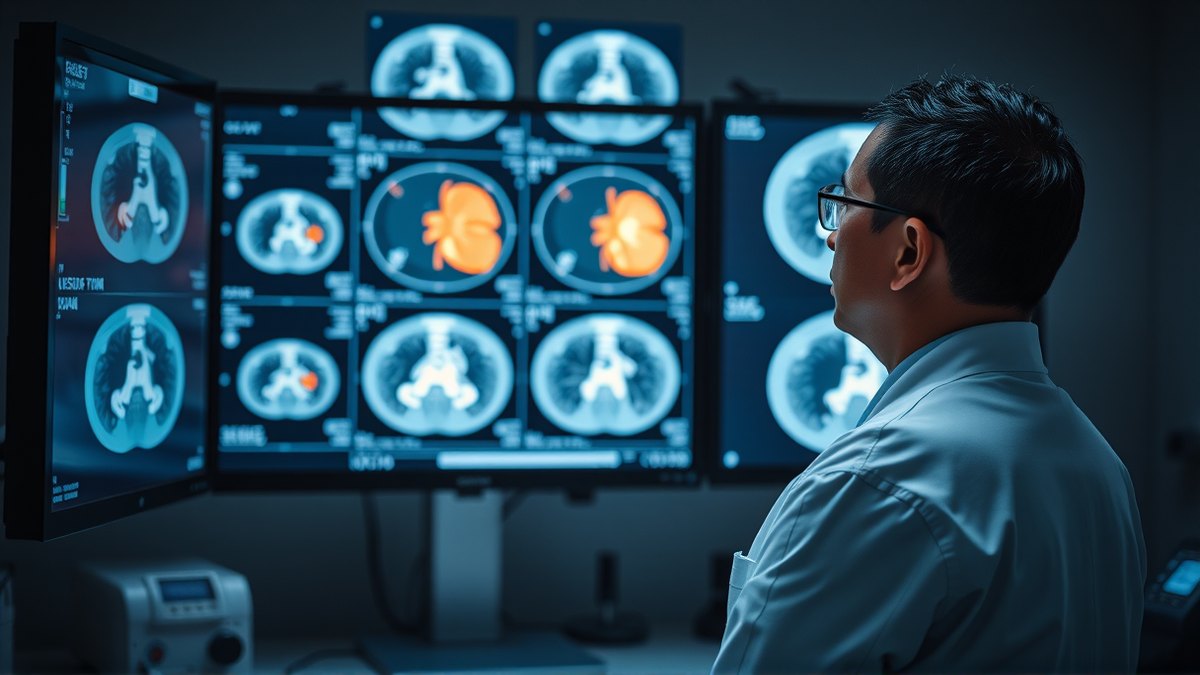
Alibaba DAMO Academy et le premier hôpital rattaché à la faculté de médecine de l'université du Zhejiang ont publié le 18 septembre 2026 dans la revue Science le modèle DAMO RADAR. Un seul système y reconnaît 146 types de lésions dans 18 organes de l'abdomen, à partir d'un examen tomodensitométrique avec produit de contraste.
Jusqu'ici, l'imagerie médicale suivait la voie « une maladie, un modèle ». Le nodule pulmonaire, le cancer du pancréas ou la rétinopathie diabétique avaient chacun leurs outils. Selon DAMO, ces modèles « dépendent largement d'annotations manuelles et coûtent cher : l'entraînement pour une seule maladie prend généralement deux ans. Une fois entraînés, ils ne généralisent pas à d'autres atteintes ». Le modèle général doit réduire cette dépendance.
RADAR a été mis à l'épreuve sur une tâche difficile. Un examen CT contient des centaines de coupes. Les organes de l'abdomen se chevauchent et ont une densité proche, ce qui rend le signal des lésions parfois très subtil. Le modèle a appris en même temps l'image et le langage : les données d'image ont été associées aux descriptions des comptes rendus diagnostiques. Le mécanisme identifie d'abord l'organe, foie, pancréas ou tube digestif, avant de le relier à la description du compte rendu. Il ne se laisse donc pas distraire par le fond des tissus sains.
Ses résultats face aux médecins
L'évaluation a porté sur 18 organes et 146 maladies. Sur près de 40 000 examens réels, l'AUC moyenne s'établit à 0,913. Cette mesure traduit la capacité à distinguer une personne malade d'une personne saine, 1,0 correspondant à un résultat parfait. Pour comparer le modèle aux humains, les équipes ont invité 26 radiologues de 14 centres : 11 expérimentés et 15 moins anciens. Médecins et modèle ont évalué les examens CT de 300 patients. En moyenne, RADAR a fait mieux que 23 des 26 médecins. Seuls trois radiologues expérimentés ont obtenu des résultats légèrement supérieurs au modèle.
Dans le test de collaboration entre l'homme et la machine, les suggestions du modèle ont fait grimper la sensibilité de détection des maladies d'environ 10 pour cent, et le temps moyen de lecture d'un cas a diminué de 30,7 pour cent. Sur une partie des tests, les jeunes radiologues aidés par l'IA ont atteint une sensibilité supérieure à celle de leurs aînés sans assistance.
DAMO compare le modèle général à la navigation : il ne remplace pas le médecin au moment de poser le diagnostic final, il signale les maladies possibles et les zones faciles à manquer. « Le cœur d'un modèle dédié, c'est la haute précision ; le cœur d'un modèle général, c'est la large couverture », affirme l'entreprise. Les deux approches ne sont pas concurrentes, ajoute-t-elle, elles conviennent à des scénarios cliniques différents.
Le code de l'algorithme et les poids du modèle sont entièrement publics, pour la médecine et la science dans le monde entier. La publication ne vaut toutefois pas déploiement : la valeur réelle dépendra des tests menés dans d'autres hôpitaux et sur des populations autres que celle de l'entraînement.
Sources
2Tous les chiffres et citations de ce texte proviennent des sources citées ci-dessous.
Les contenus ont été préparés par l'équipe de rédaction, assistée par l'IA.
Amélie Bernard
Commentaires
0- Aucun commentaire — soyez le premier.