DAMO RADAR: jeden model rozpoznaje 146 chorób w 18 narządach jamy brzusznej
Chiński model ogólny dla obrazowania medycznego opisano 18 września 2026 w czasopiśmie Science. Średnie AUC w blisko 40 tysiącach badań wyniosło 0,913, a algorytm i wagi udostępniono publicznie.
 Renata PawlakNauka i zdrowie
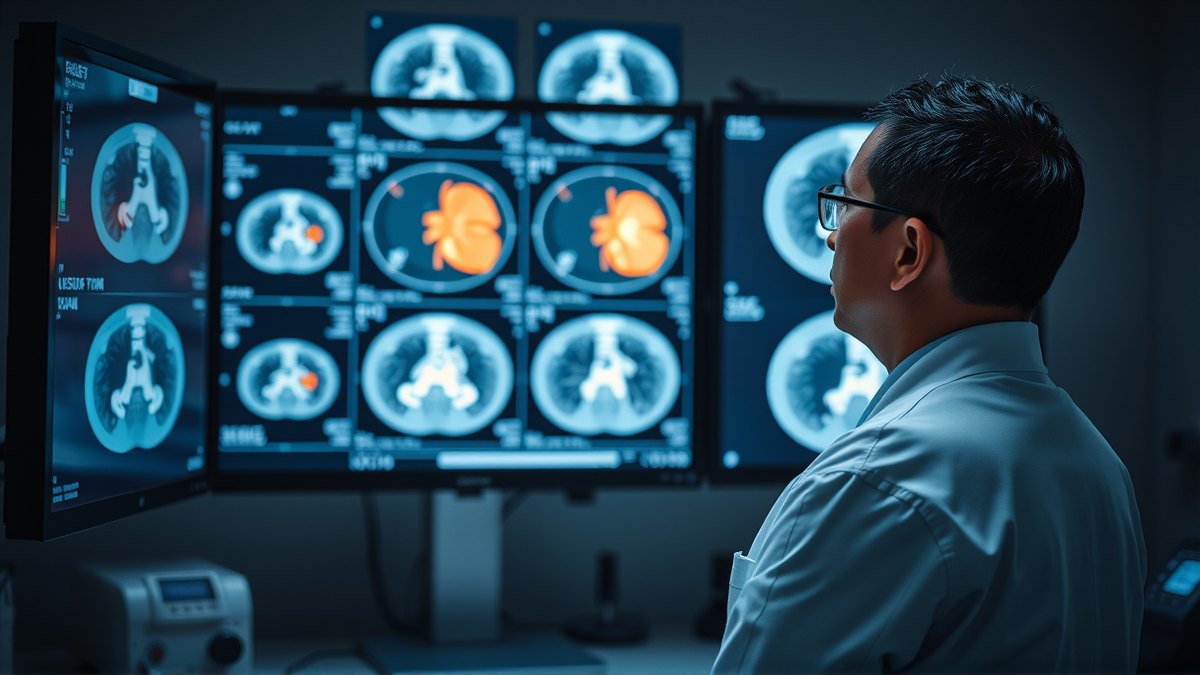
Alibaba DAMO Academy wspólnie z pierwszym szpitalem afiliowanym przy Szkole Medycznej Uniwersytetu Zhejiang opublikowała 18 września 2026 roku w czasopiśmie Science model DAMO RADAR. To ogólny model obrazowania medycznego: pojedynczy system rozpoznaje 146 rodzajów schorzeń w 18 narządach anatomicznych jamy brzusznej na podstawie kontrastowego badania tomografii komputerowej.
Dotychczas obrazowanie medyczne szło ścieżką „jedna choroba, jeden model”. Guzek płucny, rak trzustki czy retinopatia cukrzycowa miały osobne narzędzia. Według DAMO takie modele „w dużej mierze zależą od ręcznych oznaczeń, są kosztowne, bo trening dla jednej choroby zajmuje zwykle dwa lata, a po wytrenowaniu nie generalizują na inne schorzenia”. Model ogólny ma tę zależność zmniejszać.
RADAR wybrano do trudnego zadania. Jedno badanie CT zawiera setki przekrojów, a narządy jamy brzusznej nachodzą na siebie i mają zbliżoną gęstość, przez co sygnał zmian bywa bardzo subtelny. Model uczył się jednocześnie obrazu i języka. Dane obrazowe łączono z opisami w raportach diagnostycznych, a mechanizm najpierw rozpoznaje narząd, na przykład wątrobę, trzustkę albo przewód pokarmowy, i dopiero potem wiąże go z opisem w raporcie. Dzięki temu nie rozprasza go tło z prawidłowych tkanek.
Jak wypadł na tle lekarzy
Ewaluacja objęła 18 narządów i 146 chorób. W blisko 40 tysiącach rzeczywistych badań średnie AUC wyniosło 0,913. To miara zdolności rozróżnienia osoby chorej od zdrowej, gdzie 1,0 oznacza wynik idealny. Aby porównać model z ludźmi, zespoły zaprosiły 26 radiologów z 14 ośrodków: 11 doświadczonych i 15 z mniejszym stażem. Lekarze i model oceniali badania CT 300 pacjentów. Średnio RADAR wypadł lepiej niż 23 z 26 lekarzy. Jedynie trzech doświadczonych radiologów uzyskało wyniki nieco wyższe od modelu.
W teście współpracy człowieka z maszyną podpowiedzi modelu podniosły czułość rozpoznawania chorób o około 10 procent, a średni czas czytania jednego przypadku skrócił się o 30,7 procent. W części testów młodsi radiolodzy korzystający z podpowiedzi AI osiągnęli czułość wyższą niż starsi koledzy bez wsparcia.
DAMO porównuje model ogólny do nawigacji. Nie zastępuje lekarza w stawianiu ostatecznej diagnozy, tylko wskazuje możliwe choroby i obszary, które łatwo przeoczyć. „Rdzeniem modelu dedykowanego jest wysoka precyzja, rdzeniem modelu ogólnego szerokie pokrycie” — przekonuje firma i dodaje, że obie drogi nie konkurują, lecz sprawdzają się w różnych scenariuszach klinicznych.
Kod algorytmu i wagi modelu są w całości udostępnione publicznie dla medycyny i nauki na całym świecie. Sama publikacja to jednak nie to samo co wdrożenie. O rzeczywistej wartości zdecydują testy w kolejnych szpitalach i populacjach innych niż treningowa.
Źródła
2Wszystkie liczby i cytaty w tym tekście pochodzą z poniższych źródeł. Nie dopisujemy danych, których w źródłach nie ma.
Materiały zostały przygotowane przez zespół redakcyjny wspierane przez AI.
Renata Pawlak
Komentarze
0- Brak komentarzy — bądź pierwszy.